使用 RAGFlow
1. 配置模型

LLM:是大语言模型,用于 RAGFlow 中的聊天功能;如果不使用 RAGFlow 中的聊天功能也可以不设置此模型;
Embedding:是向量模型,用于将输入文本转为数字向量,然后交给 Elasticsearch 进行检索。
VLM:视频语言模型,用于将要入库的图片、流程图、截图等视觉内容转为文本,以供 Embedding 模型向量化;
ASR:语音识别模型,用于将要入库的语音转换文字,以供 Embedding 模型向量化;
Rerank:重排序模型,用于对初步检索结果重新评估相关性;
TTS:语音合成模型,用于最终输出的文字转换语音播放给用户听;
文档入库流程:

知识检索流程:

2. 检索引擎
Elasticsearch :不仅支持全文检索,还支持向量检索(Vector Search),甚至可以同时进行全文检索和向量检索(Hybrid Search,混合检索)。
3. 切换模型
Embedding 模型并不是可以无成本替换的。知识库一旦完成向量完成,后续更换 Embedding 模型通常需要重新构建向量索引。因为不同 Embedding 模型生成的向量通常不属于同一个向量空间,不能直接混合比较。例如:分别使用模型 A 和模型 B 生成的向量如下:
模型 A:
[0.12, -0.35, 0.87, 0.21, ...]
  └── 假设为 1024 维向量

模型 B:
[-0.45, 0.18, 0.63, 0.92, ...]
  └── 假设为 1536 维向量
VLM 和 ASR 模型用于将视觉 和语音文件转为文本,因此理论上这两个模型可随时切换;但要在 RAGFlow 中找到这些结果文本,并重新与原始输入文档共同进行向量化,可能会比较麻烦。
其它模型切换都很容易。
4. 创建知识库

解析方法:内置 表示使用 RAGFlow 内置的文档解析与分块策略,配置简单,适合快速测试;Pipeline 是指使用预先定义的文档处理流水线, 适合大量 Word、PPT、PDF 混合,并且需要精细处理复杂表格、架构图和规范章节的场景。
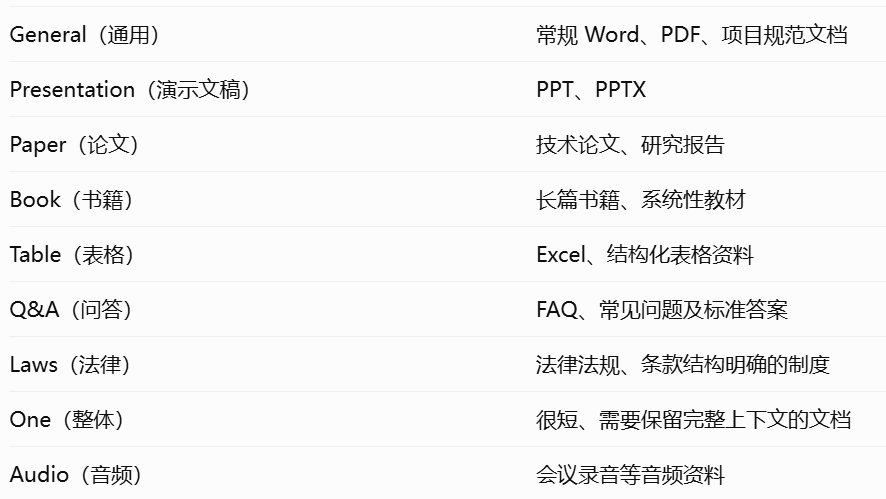
分块方法:
5. 向知识库中上传文档
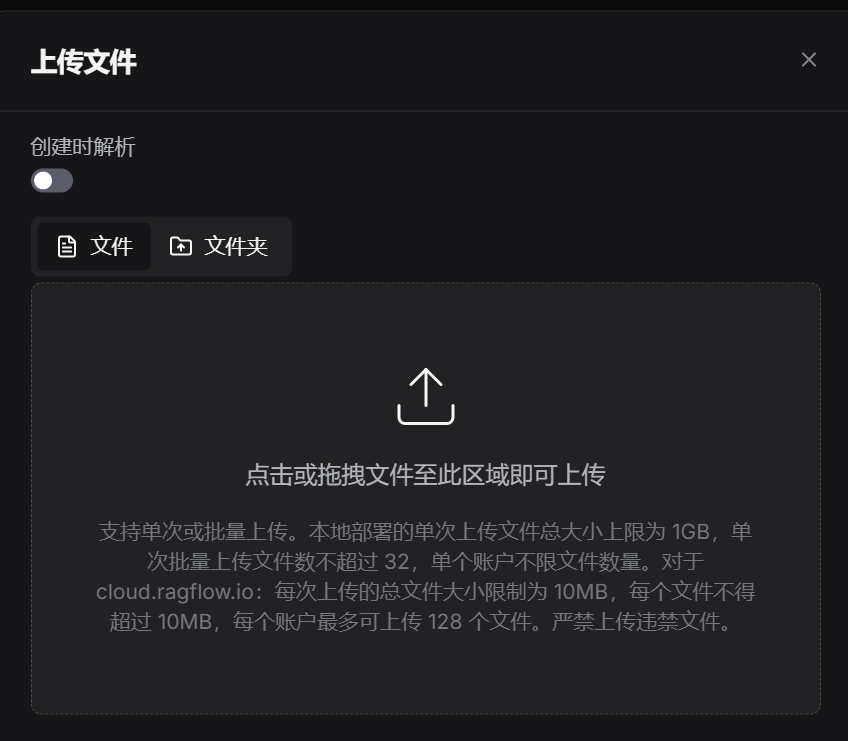
上传文档时有一个“创建时解析”的选项;如果文件没有经过解析,就无法参与 RAGFlow 的正常知识库检索,但文件仍然可以上传、保存和管理。
“创建时解析”这个选项存在的主要作用是:将文件上传与文档解析分离,让用户自行决定什么时候消耗计算资源、调用模型并建立检索索引。例如下:
- 批量上传文件,稍后统一解析,以避免短实践占用大量硬件资源或模型API配额;
- 批量上传后,先进行小范围向量化配置和测试,然后再决定是否全部解析。
6. 批量上传目录
RAGFlow 的产品定位是 RAG(检索增强生成)引擎,而不是企业文件管理系统,因此其对文件上传管理支持的并不友好;要通过 RAGFlow API 才能批量上传带有层级结构的本地目录;例如下:
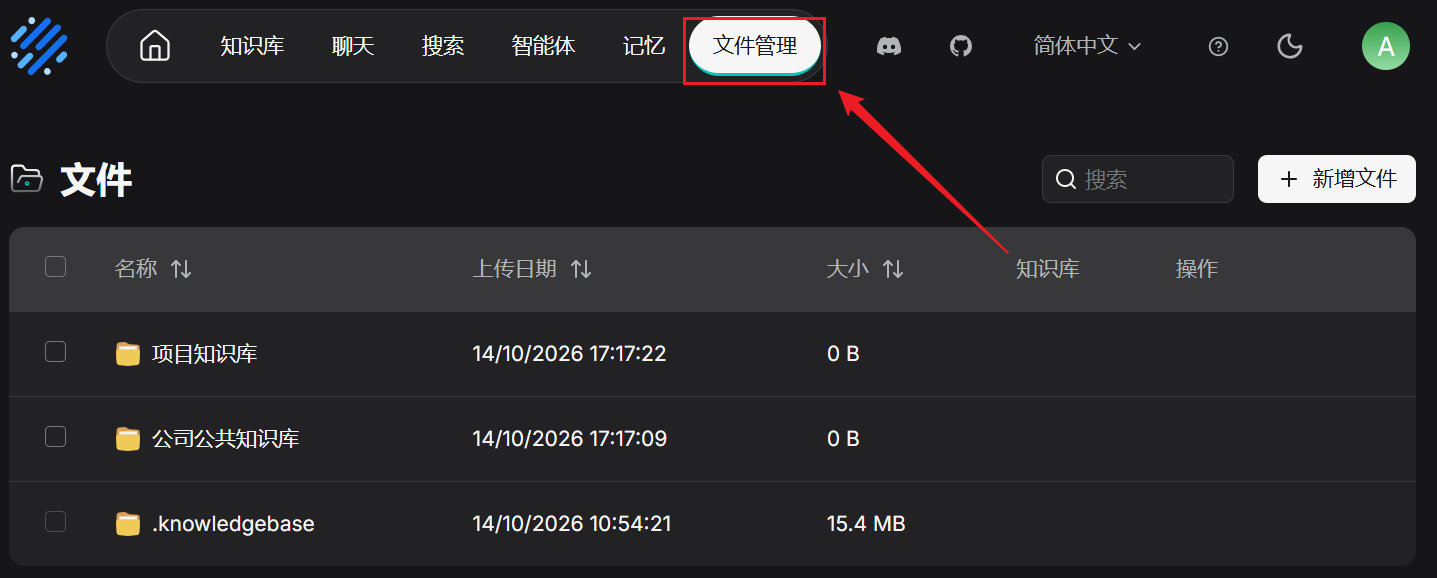
然后链接到指定知识库,例如下:
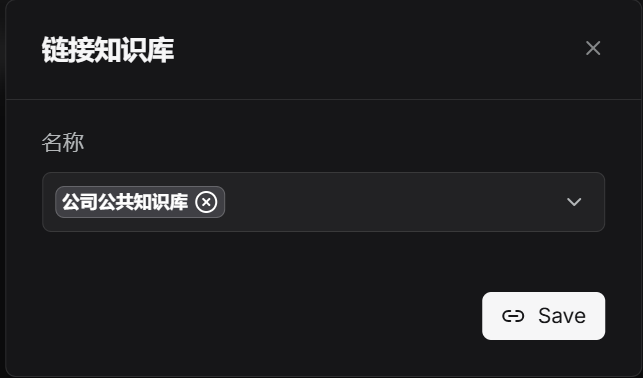
7. 获取 RAGFlow API Key
RAGFlow API Key 用于通过脚本操作 RAGFlow,例如:AI客户端MCP调用、RAGFlow批量文件上传等。
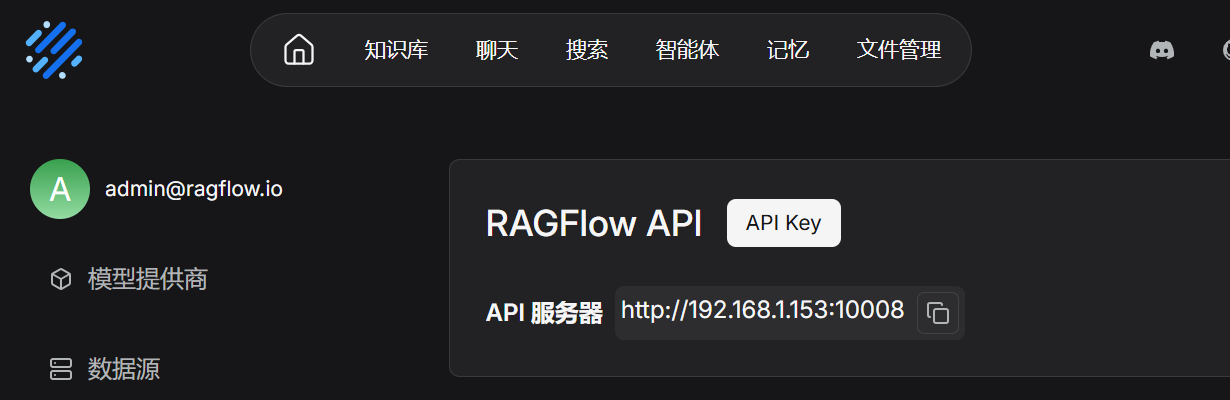
8. 获取知识库ID
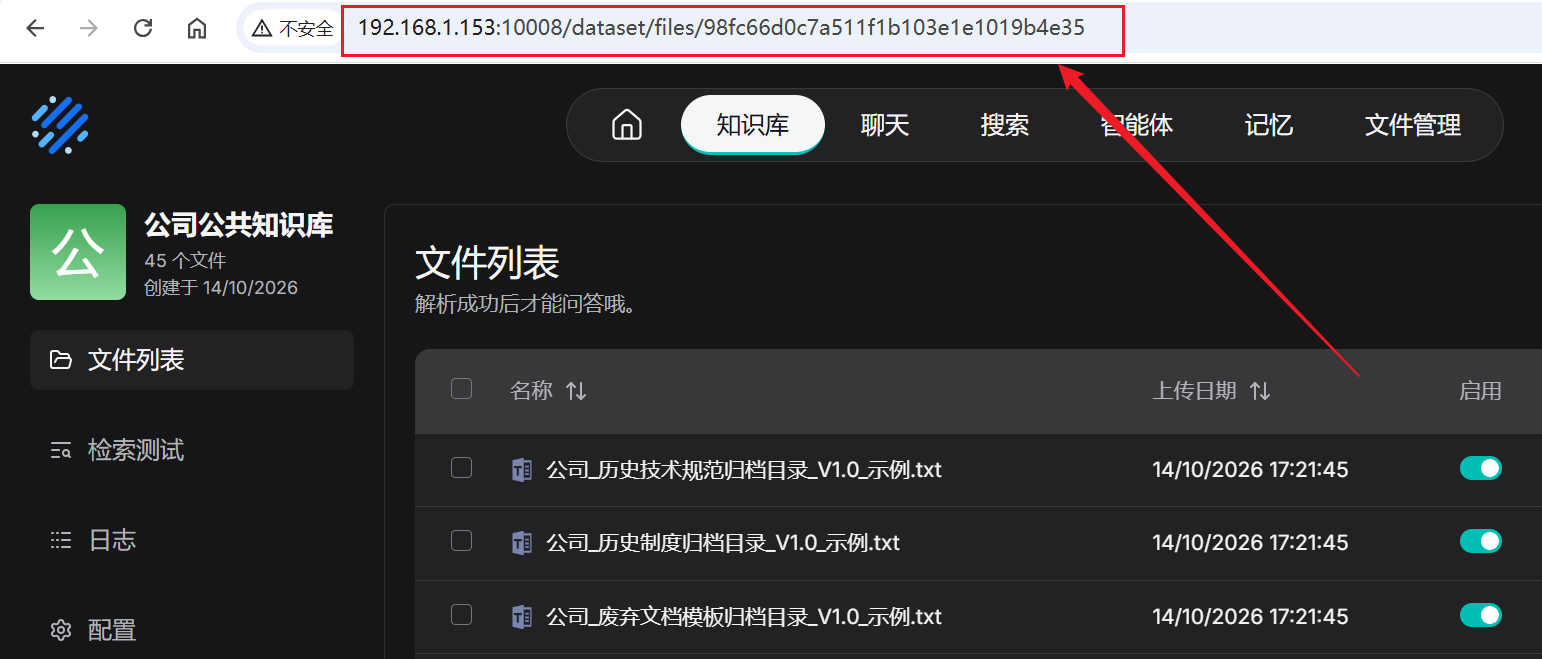
打开 知识库 -> 选择某个知识库,然后URL中能看到知识库ID
docker compose -f docker-compose.yml logs --tail=200 ragflow-cpu
这份日志还没有包含 MCP 启动失败的具体原因:最近 200 条主要是正常的 API 请求,没有 MCP 启动记录。
能确定的是:
/api/v1/retrieval返回 200,知识库检索正常。/api/v1/mcp返回 404,这个 Python 部署没有该路由。/api/v1/mcp/servers返回 200 是 RAGFlow 管理外部 MCP 的接口,不能证明它自身的 MCP 服务已启动。- 开头的
ValueError缺少前面的调用栈,暂时无法判断来源。
请在部署服务器的 CMD 中执行下面三条命令,定位实际启动参数和早期日志:
docker inspect docker-ragflow-cpu-1 --format "{{json .Config.Cmd}}"
docker compose -f docker-compose.yml logs --no-color ragflow-cpu 2>&1 | findstr /i /c:"MCP" /c:"Traceback" /c:"Error" /c:"9382" /c:"Uvicorn"
docker compose -f docker-compose.yml exec ragflow-cpu bash -lc "ps -ef | grep '[m]cp/server/server.py'"
第一条结果应包含 --enable-mcpserver、--mcp-host=0.0.0.0 和 --mcp-mode=host;第三条应看到 MCP Python 进程。
如果第一条没有启用参数,说明修改尚未应用到运行中的容器。确认 Compose 的 command 已加入之前的参数后,执行:
docker compose -f docker-compose.yml up -d --no-deps --force-recreate ragflow-cpu
这会短暂重启 RAGFlow 应用容器。把上述三条诊断命令的输出贴过来,就能进一步区分“未启用”“进程退出”或“监听地址错误”。
有可能,但目前还没有证据确认。 宿主机内存占用 96% 时,MCP 进程可能启动失败或被终止;不过,之前已经确认过容器缺少 MCP 启动参数,也会造成同样的连接失败。
请在部署服务器执行:
docker inspect docker-ragflow-cpu-1 --format "Args={{json .Config.Cmd}} OOMKilled={{.State.OOMKilled}} RestartCount={{.RestartCount}}"
docker stats --no-stream
docker compose -f docker-compose.yml logs --no-color ragflow-cpu 2>&1 | findstr /i /c:"MCP" /c:"Traceback" /c:"MemoryError" /c:"Killed" /c:"9382" /c:"Uvicorn"
判断方式:
- Args 没有
--enable-mcpserver:配置仍未生效,先解决启动参数。 OOMKilled=true:容器发生过内存不足终止。- 日志出现
MemoryError或Killed:支持内存不足的判断。 OOMKilled=false:也不能完全排除 MCP 子进程单独被终止。
可以先关闭宿主机上不需要的程序、释放内存,再重建 RAGFlow 应用容器:
docker compose -f docker-compose.yml up -d --no-deps --force-recreate ragflow-cpu
把检查输出发来,就能进一步判断。暂时不建议盲目调小 Elasticsearch 或容器内存限制,否则可能加重故障。